Faire tourner l'IA sur sa propre machine : le vrai état des lieux en local
L’argument de l’IA locale est simple et globalement vrai : confidentialité, pas de facture d’API, fonctionne en avion. L’argument escamote discrètement la partie où votre téléphone ralentit, la batterie de votre portable se dégrade, et le matériel que vous possédez compte davantage que le modèle que vous avez téléchargé.
Des chercheurs ont évalué le même modèle — Qwen 2.5 1.5B en quantification 4 bits — sur quatre machines très différentes, avec une invite identique de 258 jetons, un décodage glouton et 20 itérations consécutives par appareil (arXiv:2603.23640, juin 2026).
Le matériel
| Appareil | Accélérateur |
|---|---|
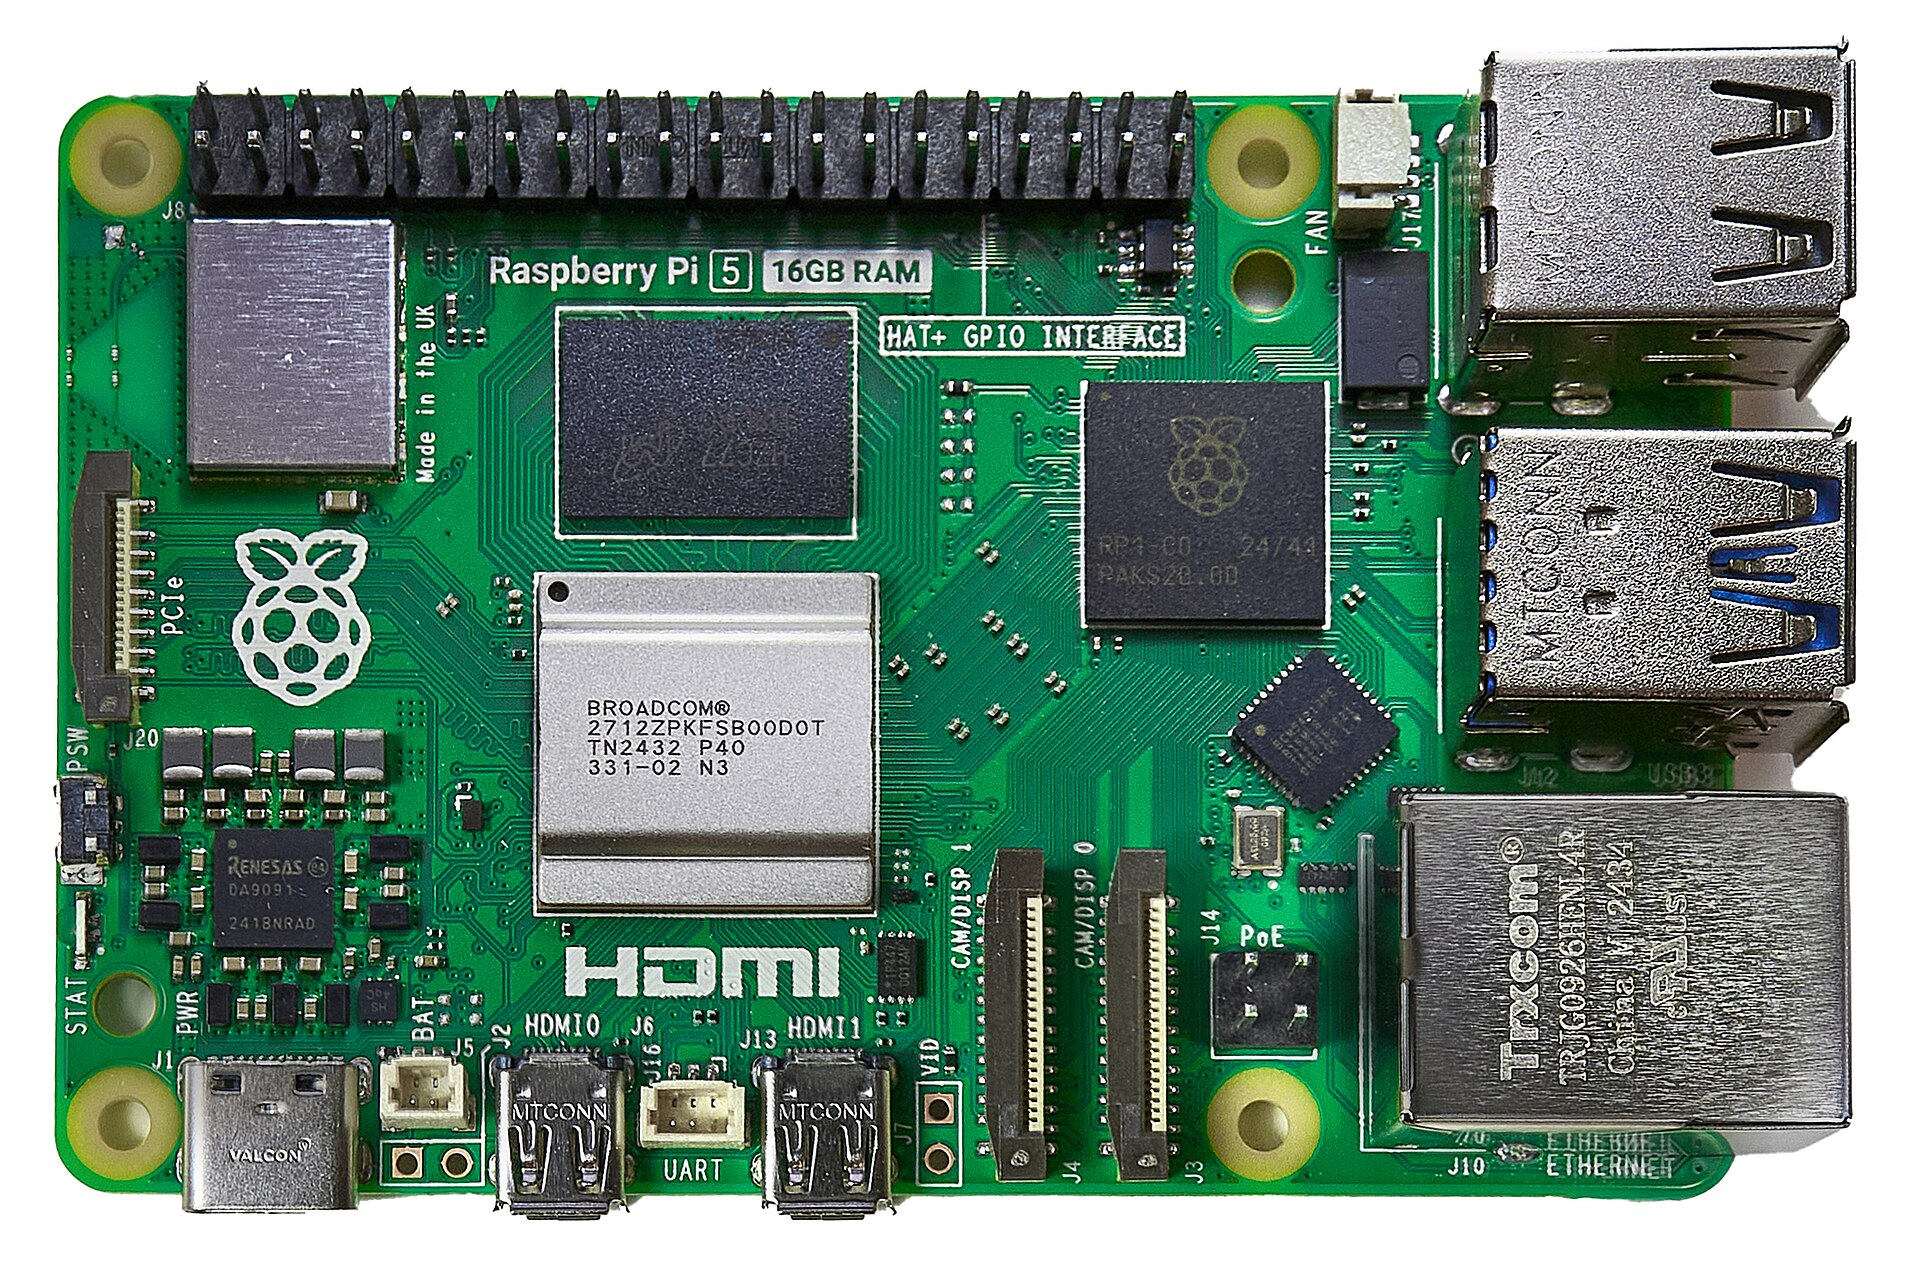
| Raspberry Pi 5 | NPU Hailo-10H M.2 |
| Samsung Galaxy S24 Ultra | Snapdragon 8 Gen 3 (NPU intégré) |
| iPhone 16 Pro | A18 Pro |
| Ordinateur portable | NVIDIA RTX 4050 (sur batterie) |
Les résultats
| Appareil | Débit | Consommation | Comportement |
|---|---|---|---|
| RTX 4050 | 131,7 tok/s | 34,1 W | Plafonné par la batterie |
| iPhone 16 Pro | pic >40 tok/s | — | Perd 38,4 % en 2 itérations |
| S24 Ultra | — | — | Plancher de fréquence GPU imposé par l’OS ; inférence interrompue |
| Hailo-10H | 6,9 tok/s | moins de 2 W | Variance quasi nulle |
Trois conclusions sortent directement de ce tableau.
Premièrement, la gestion thermique l’emporte sur la pointe de calcul sur mobile. L’iPhone a démarré au-dessus de 40 jetons par seconde, puis le régulateur thermique d’iOS l’a fait passer de l’état normal à l’état chaud : le débit a chuté de 38,4 % en deux itérations. Pas vingt. Deux.
Deuxièmement, le Samsung a fait quelque chose de pire que ralentir. Il a atteint un plancher de fréquence GPU imposé par le système qui a interrompu l’inférence. C’est le mode de défaillance que personne ne budgète : pas une sortie dégradée, aucune sortie.
Troisièmement, la puce lente a gagné en efficacité énergétique. Le Hailo-10H a tenu 6,9 tok/s sous 2 watts — un débit 19 fois inférieur à celui du GPU portable, mais une proportionnalité énergétique comparable. Pour un assistant toujours actif qui passe la majeure partie de la journée inactif, c’est précisément l’arbitrage que vous voulez.
Pourquoi cela dépasse le cadre du banc d’essai
Les appareils deviennent vite abordables. Une étude d’accompagnement (arXiv:2604.24785) cite des accélérateurs comme le Hailo-10H à 40 TOPS, le Jetson Orin Nano Super à 67 TOPS, et des NPU intégrés apportant un calcul IA utilisable sur du matériel à moins de 350 dollars.
La même étude rapporte qu’une quantification INT4 réduit la taille des modèles de 4× à 16× par rapport au FP16 — soit 75 % à 93,75 % de réduction — avec des mesures matérielles montrant 57 % à 61 % de réduction de surface et de consommation.
Le pipeline fonctionne donc. Mais le classement d’efficacité n’est pas celui que suggère le marketing matériel. Le M5Stack et le GPU Jetson se sont classés à 0,5–1,7 MJ/Mtok, les plus efficaces du groupe. Le Raspberry Pi avec son chapeau NPU a varié de 0,8 à 5,5 MJ/Mtok bien davantage selon le modèle. Cela suggère que l’efficacité d’un NPU est plus sensible à l’architecture du modèle que celle d’un GPU — un détail qui piégera quiconque suppose qu’un NPU est interchangeable.
Le silicium spécialisé va plus loin. EdgeCIM (arXiv:2604.11512) rapporte jusqu’à 7,3× plus de débit et 49,56× meilleure efficacité énergétique qu’un NVIDIA Orin Nano sur LLaMA3.2-1B, et 9,95× plus de débit qu’un Qualcomm SA8255P sur LLaMA3.2-3B. Le passage d’INT8 à INT4 double encore environ le débit et l’efficacité. En INT4, Qwen2.5-0.5B dépasse 1000 tok/s à plus de 600 tokens/J.
Rien de tout cela n’est sur votre téléphone aujourd’hui. C’est ce que ressemblera l’avenir.
Comment choisir son matériel sans laboratoire
- Décidez entre rafale et fonctionnement permanent. Le débit en rafale compte pour le travail interactif ; l’efficacité par watt compte pour les agents en arrière-plan. Ils récompensent du matériel opposé.
- Supposez une charge soutenue, pas un pic. Chaque chiffre mobile que vous avez lu est un chiffre de première itération.
- Examinez l’enveloppe thermique, pas les TOPS. Un appareil qui interrompt l’inférence ne vaut rien.
- Surveillez la bande passante mémoire, pas seulement le calcul. Le décodage moderne est limité par la bande passante : le RTX 4050 a buté sur la batterie, le Hailo-10H sur la bande passante mémoire de son module.
- Adaptez la précision à l’appareil. INT4 sur mobile, précision plus élevée sur du matériel de type serveur.
Le résumé honnête
L’IA locale est réelle et elle s’améliore. Mais « ça tourne sur ma machine » est le début d’une phrase, pas sa fin. Le modèle est la variable la moins intéressante du système. Le régulateur thermique de votre téléphone est celui qui décide si vous obtenez un assistant qui fonctionne ou un rectangle tiède qui cesse de répondre.
Sources : LLM Inference at the Edge: Mobile, NPU, and GPU (arXiv:2603.23640, juin 2026) · Cloud to Edge: Benchmarking LLM Inference on Single-Board Computers (arXiv:2604.24785) · EdgeCIM (arXiv:2604.11512, avril 2026) · Google AI Edge Portal, mai 2026