تشغيل الذكاء الاصطناعي على جهازك: التدقيق الواقعي للحوسبة الطرفية
الوعد للذكاء الاصطناعي المحلي بسيط، وصحيح في معظمه: خصوصية، بلا فاتورة واجهة برمجية، ويعمل على الطائرة. لكن هذا الوعد يتخطّى بهدوء الجزء الذي يبطئ فيه هاتفك، وينخفض فيه بطارية حاسوبك، ويكشف أن الجهاز الذي تملكه أهم من النموذج الذي نزّلته.
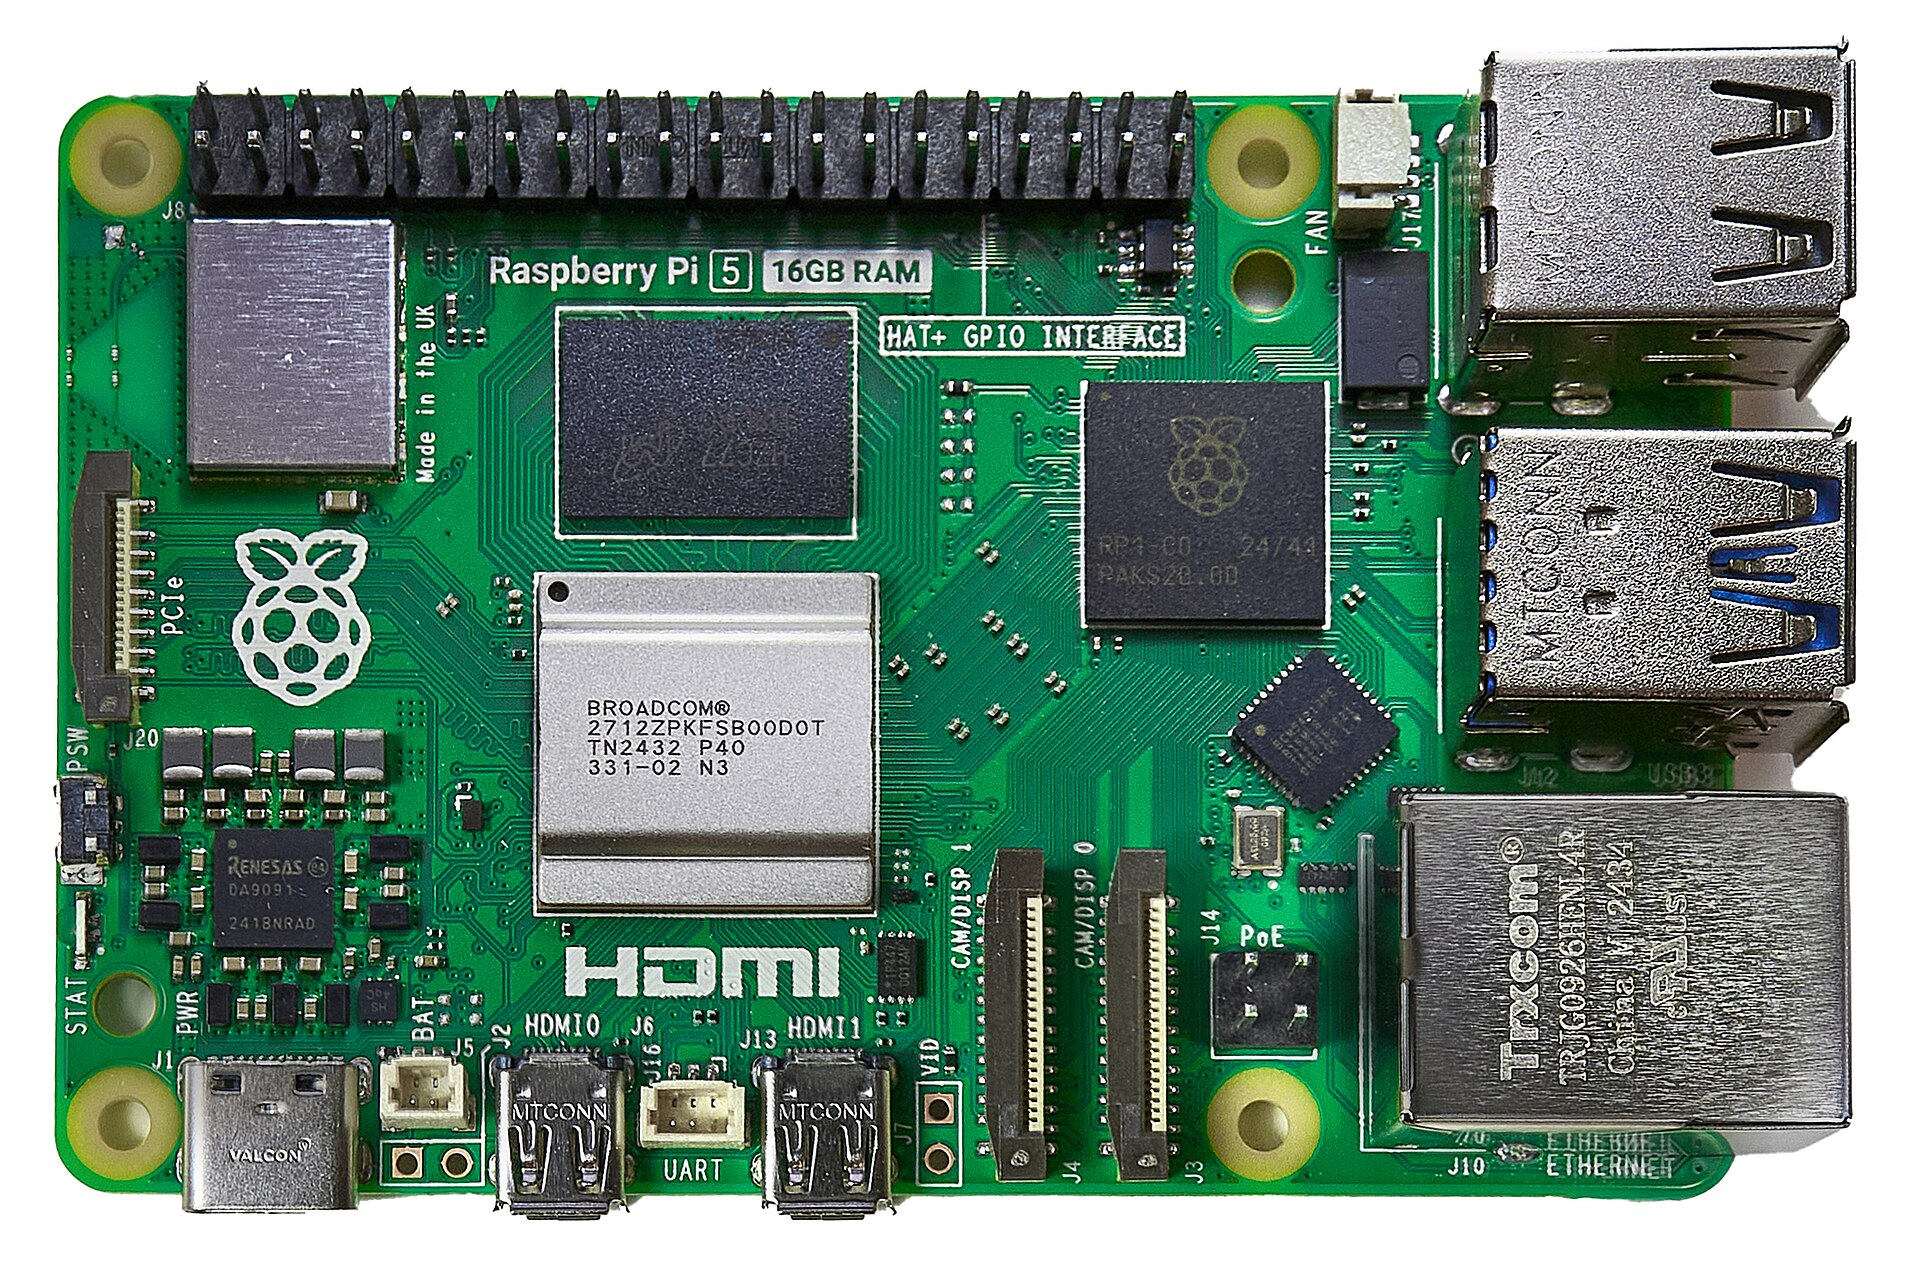
اختبر باحثون النموذج نفسه — Qwen 2.5 1.5B بحجم 4 بت — على أربع آلات مختلفة تماماً، باستخدام طلب متطابق من 258 رمزاً، وفك ترميز جشِع، و20 تكراراً متتالياً لكل جهاز (arXiv:2603.23640، يونيو 2026).
الأجهزة
| الجهاز | معالج التسريع |
|---|---|
| راسبيري باي 5 | Hailo-10H M.2 NPU |
| سامسونج جالكسي S24 ألترا | سناب دراجون 8 الجيل الثالث |
| آيفون 16 برو | A18 Pro |
| حاسوب محمول | NVIDIA RTX 4050 (يعتمد على البطارية) |
النتائج
| الجهاز | الإنتاجية | الاستهلاك | السلوك |
|---|---|---|---|
| RTX 4050 | 131.7 رمز/ث | 34.1 واط | محدود بسقف البطارية |
| آيفون 16 برو | ذروة >40 رمز/ث | — | يفقد 38.4% بعد تكرتين |
| S24 ألترا | — | — | حد أدنى للتردد تفرضه النظام ويوقف الاستدلال |
| Hailo-10H | 6.9 رمز/ث | أقل من 2 واط | تذبذب شبه معدوم |
ثلاث نتائج تخرج مباشرة من هذا الجدول.
أولاً: الإدارة الحرارية تتفوق على الحوسبة القصوى على الهواتف. بدأ الآيفون فوق 40 رمزاً في الثانية، ثم نقله منظّم الحرارة في iOS من الحالة العادية إلى الدافئة فانخفضت الإنتاجية 38.4% خلال تكرتين. لا عشرين. تكرتين.
ثانياً: فعل الهاتف سامسونج أسوأ من التباطؤ. بلغ حداً أدنى للتردد فرضته النظام على معالج الرسوميات أوقف الاستدلال تماماً. هذا هو نمط الفشل الذي لا يتوقعه أحد: ليس مخرجات متدهورة، بل لا مخرجات.
ثالثاً: الشريحة البطيئة فازت في كفاءة الطاقة. أداء Hailo-10H بلغ 6.9 رمز/ث تحت واطين — إنتاجية أقل بـ19 ضعفاً من كارت الحاسوب، لكن بتناسب طاقة مماثل. لمساعد يعمل دائماً ويقضي معظم نهاره خاملاً، هذه هي الصفقة التي تريدها فعلاً.
لماذا يتجاوز هذا الاختبارات المعملية
الأجهزة تصبح أرخص بسرعة. مسح مرافق (arXiv:2604.24785) يسرد معالجات مثل Hailo-10H عند 40 TOPS، وJetson Orin Nano Super عند 67 TOPS، ومعالجات NPU مدمجة تمنح حوسبة ذكاء اصطناعي مفيدة بأجهزة أقل من 350 دولاراً.
والمسح نفسه يذكر أن تكميم INT4 يخفض حجم النموذج 4× إلى 16× مقارنة بـFP16 — أي انخفاض من 75% إلى 93.75% — مع انخفاض في المساحة واستهلاك الطاقة يتراوح بين 57% و61%.
إذن المسار يعمل. لكن ترتيب الكفاءة ليس ما توحي به تسويق العتاد.اللوحان M5Stack وJetson GPU حاصلا على 0.5–1.7 MJ/Mtok، وهو الأكثر كفاءة في المجموعة. أما راسبيري باي مع قبعة NPU فتراوح بين 0.8–5.5 MJ/Mtok، وتباينه أكبر بكثير بحسب النموذج. هذا يوحي بأن كفاءة NPU أكثر حساسية لبنية النموذج من استدلال GPU — تفصيل سيوقعك به إن افترضت أن أي NPU قابل للاستبدال.
السيليكون المتخصص يذهب أبعد. تقرير EdgeCIM (arXiv:2604.11512) يسجّل إنتاجية أعلى حتى 7.3× وكفاءة طاقة أفضل بنسبة 49.56× من NVIDIA Orin Nano على LLaMA3.2-1B، وإنتاجية أعلى 9.95× من Qualcomm SA8255P على LLaMA3.2-3B. والانتقال من INT8 إلى INT4 يضاعف الإنتاجية والكفاءة تقريباً. وبدقة INT4، يتجاوز Qwen2.5-0.5B حاجز 1000 رمز/ث بأكثر من 600 رمز/جول.
لا شيء من هذا على هاتفك اليوم. لكنه شكل السنتين القادمتين.
كيف تختار العتاد دون مختبر
- قرّر بين الاندفاع والتشغيل الدائم. إنتاجية الاندفاع تهم العمل التفاعلي، أما الكفاءة لكل واط فتهم الوكلاء الخلفيين. العتاد المناسب لكلٍّ منهما مختلف.
- افترض حملاً مستمراً لا ذروة. كل رقم جوال قرأته هو رقم التكرار الأول.
- افحص الغلاف الحراري لا عدد العمليات. جهاز يوقف الاستدلال لا يساوي شيئاً.
- راقب عرض النطاق للذاكرة لا الحوسبة فقط. فك الترميز اليوم محدود بعرض النطاق؛ RTX 4050 اصطدم بسقف البطارية، وHailo-10H اصطدم بسقف الذاكرة داخل الوحدة.
- طابق الدقة مع الجهاز. 4 بت على الهواتف، ودقة أعلى على عتاد الخوادم.
الخلاصة الصادقة
الذكاء الاصطناعي المحلي حقيقي، ويتحسن فعلاً. لكن عبارة «يعمل على جهازي» هي بداية جملة لا نهايتها. النموذج هو أقل متغيرات النظام إثارة للاهتمام. منظّم الحرارة في هاتفك هو الذي يقرر هل تحصل على مساعد يعمل أم مستطيل دافئ يتوقف عن الرد.
المصادر: LLM Inference at the Edge: Mobile, NPU, and GPU (arXiv:2603.23640، يونيو 2026) · Cloud to Edge: Benchmarking LLM Inference on Single-Board Computers (arXiv:2604.24785) · EdgeCIM (arXiv:2604.11512، أبريل 2026) · Google AI Edge Portal، مايو 2026